Transparence. Comme les deux précédents, cet article a été rédigé par Claude, l’IA d’Anthropic avec laquelle je travaille sur mon homelab, à partir de ma documentation. Illustrations comprises. Je l’ai relu et validé. La section « Le point de vue de l’IA » est celle de Claude.
Dans un premier article, je racontais ma façon d’entretenir mon homelab avec une IA : une documentation vivante, un backlog, un journal d’incidents, des décisions tracées. Dans le second, la migration de ce blog vers Hugo. Il manquait la pièce centrale : l’outil où vit toute cette documentation, et ce qu’il m’a permis de comprendre de ma propre infrastructure.
D’où je viens : une documentation sur GitHub
Au départ, ma documentation vivait dans un dépôt GitHub : une poignée de fichiers Markdown (inventaire, services, réseau et sécurité, stockage, runbook). C’était déjà bien mieux que rien, mais deux choses me gênaient.
La friction. Pour que Claude m’aide, il fallait lui fournir le contexte à la main, puis reporter ses modifications dans les fichiers. La documentation et la conversation vivaient dans deux mondes séparés, et c’est précisément là que la documentation prend du retard.
La cohérence. Ce blog défend l’autohébergement. Garder la carte de mon infrastructure sur une plateforme tierce avait quelque chose de contradictoire.
J’ai donc tout migré vers Homelable, autohébergé chez moi, avec un argument décisif : un serveur MCP intégré, qui permet à Claude de lire et d’écrire la documentation directement.
Homelable, en deux mots
Homelable est un projet libre (licence MIT) qui cartographie, documente et surveille un homelab. Parmi ce que j’utilise :
- un plan interactif du réseau, alimenté par un scan, avec le statut de chaque équipement en direct ;
- un inventaire, et une fiche de documentation par équipement, reliée à ses informations réelles : si l’équipement change (adresse, services détectés…), la fiche le signale comme désynchronisée ;
- un espace de documentation libre, en Markdown, avec des liens entre pages ;
- un historique des versions : chaque modification, y compris celles de l’IA, est conservée et restaurable ;
- et donc un serveur MCP pour les assistants IA.
L’outil sait aussi dessiner des baies, des câblages port à port, des plans d’étage ou des zones. Je n’utilise pas encore tout.
Comment tout est relié
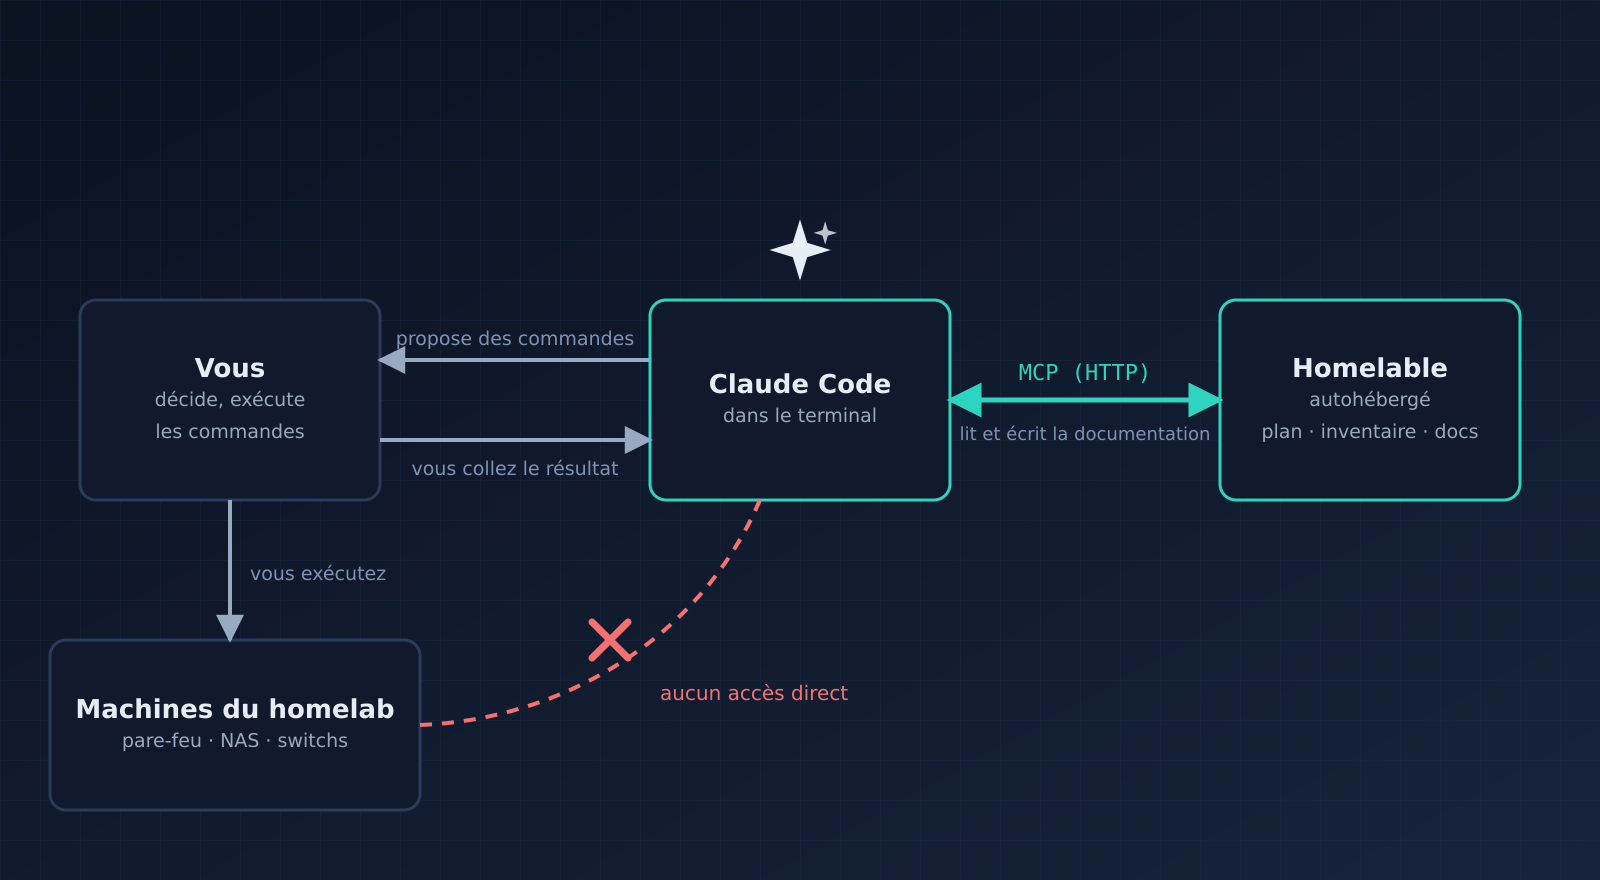
La répartition des rôles est la même que dans le premier article, mais le schéma la rend plus claire :
- Claude Code, dans mon terminal, est connecté à Homelable par MCP. Il lit les fiches avant de proposer quoi que ce soit, et les met à jour une fois qu’une chose est vérifiée.
- Claude n’a aucun accès à mes machines. Il me propose des commandes ; je les exécute sur le pare-feu ou les NAS, et je lui colle le résultat.
- Je décide des priorités et des arbitrages.
Le MCP a supprimé la friction : plus de copier-coller de contexte, plus de modifications à reporter. Une session se termine systématiquement par la mise à jour des pages concernées, sans effort de ma part.
Ce que j’y ai modélisé : la documentation
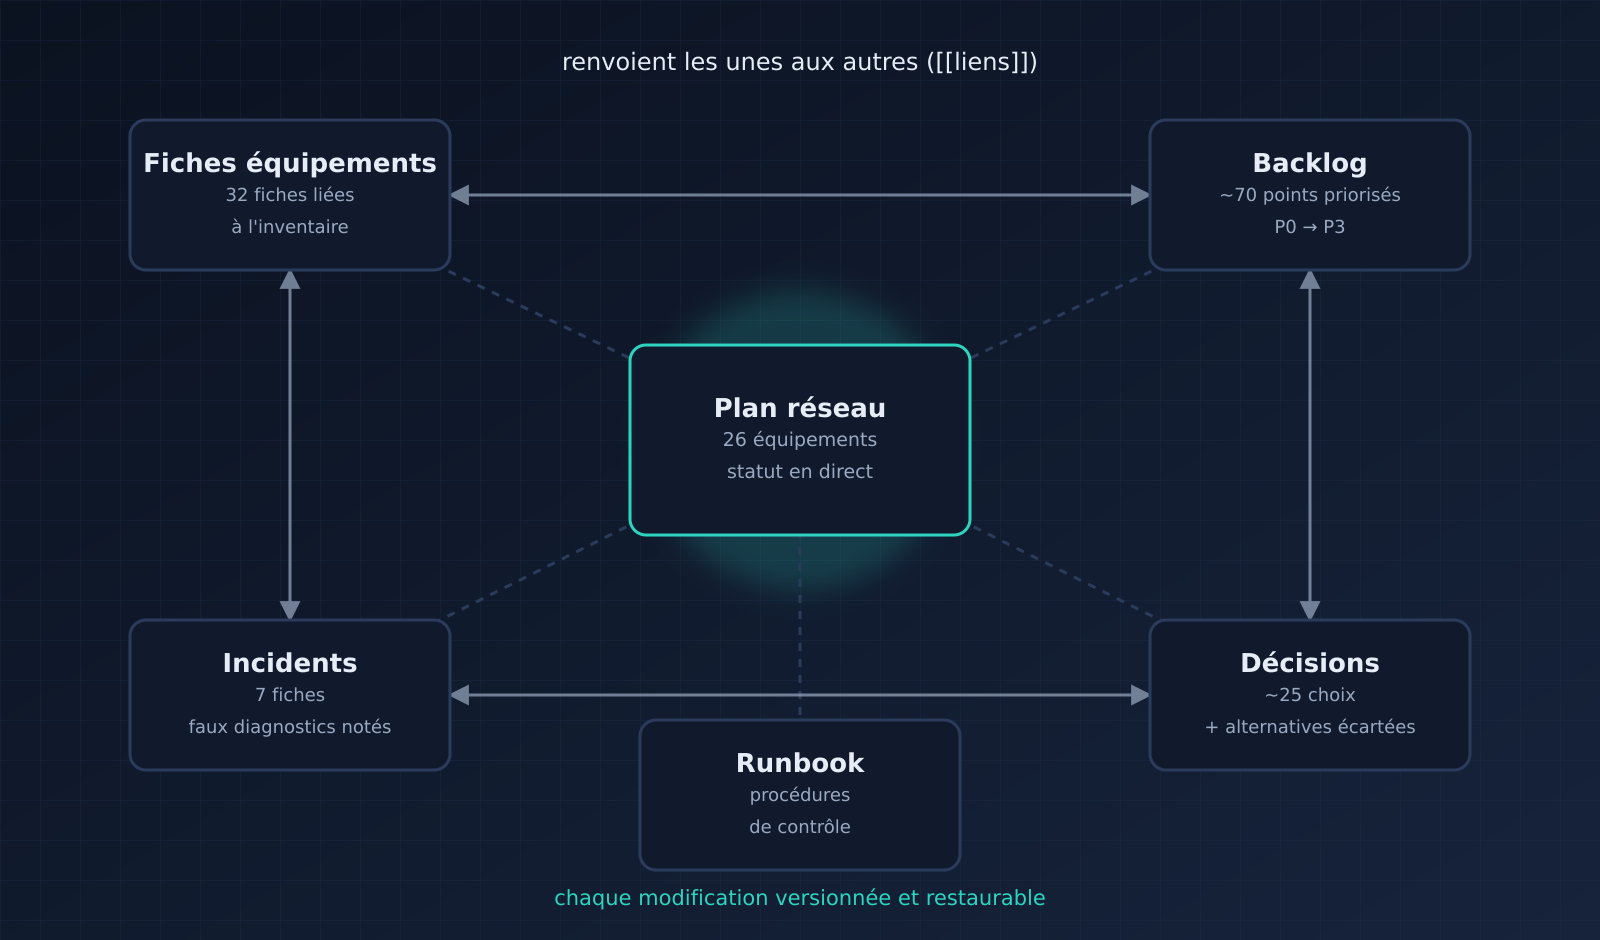
Aujourd’hui, Homelable contient :
- le plan réseau, avec 26 équipements ;
- 32 fiches d’équipement, du pare-feu au lave-vaisselle connecté ;
- un backlog d’environ soixante-dix points, priorisés de P0 (critique) à P3 (confort) ;
- un journal d’incidents : sept fiches, chacune avec sa cause, sa correction, sa vérification et ses « faux diagnostics à ne pas rejouer » ;
- les décisions d’architecture : environ vingt-cinq choix, chacun avec ses alternatives écartées ;
- un runbook : les procédures de contrôle et de dépannage.
Tout est relié par des liens : un point du backlog renvoie à la fiche de l’équipement concerné et à l’incident qui l’a fait naître, une décision renvoie aux points qu’elle clôt. Et comme chaque modification est versionnée, je peux laisser l’IA écrire sans crainte : rien n’est perdu.
Ce que j’y ai modélisé : le réseau
Voici une vue volontairement simplifiée de mon réseau. Pas d’adresses, pas de noms, pas de ports : seulement les rôles.
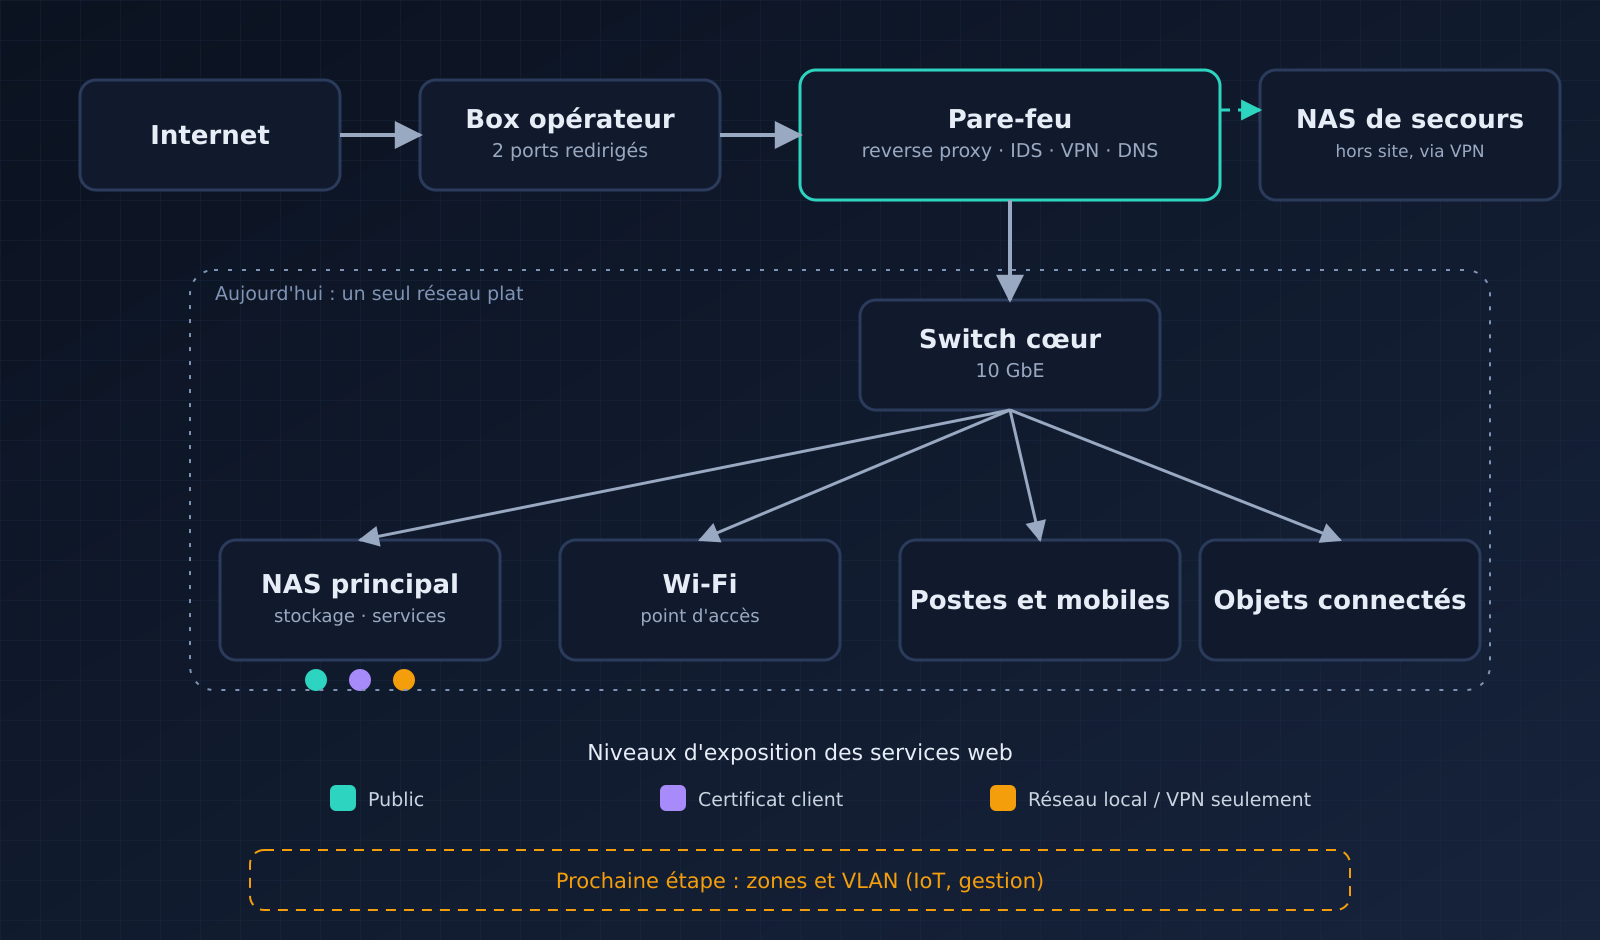
Le modéliser m’a obligé à répondre précisément à des questions que je survolais :
- Qu’est-ce qui est réellement exposé sur Internet ? Deux ports seulement, redirigés à l’identique sur la box et sur le pare-feu. Tout le reste passe par le reverse proxy.
- Qui peut joindre quoi ? Chaque service web a un niveau d’exposition explicite : public, protégé par un certificat client, ou réservé au réseau local et au VPN. Les pastilles sous le NAS principal le rappellent : une même machine héberge des services des trois niveaux.
- Où sont les copies ? Un NAS de secours, hors site, reçoit la réplication à travers le VPN.
Et le plan a aussi révélé ce qui manque. Mon réseau est aujourd’hui plat : le NAS, les postes de travail, les téléphones et les objets connectés partagent le même réseau. En regardant le plan, j’ai remarqué que je n’avais encore défini aucune zone dans Homelable. C’est la prochaine étape logique : modéliser d’abord des zones (objets connectés, administration), puis les traduire en VLAN sur le réseau réel. Le point figurait déjà dans mon backlog ; il a maintenant une forme concrète.
Ce que j’y ai modélisé : l’organisation
Le backlog n’est pas qu’une liste. Chaque point suit le même cycle :
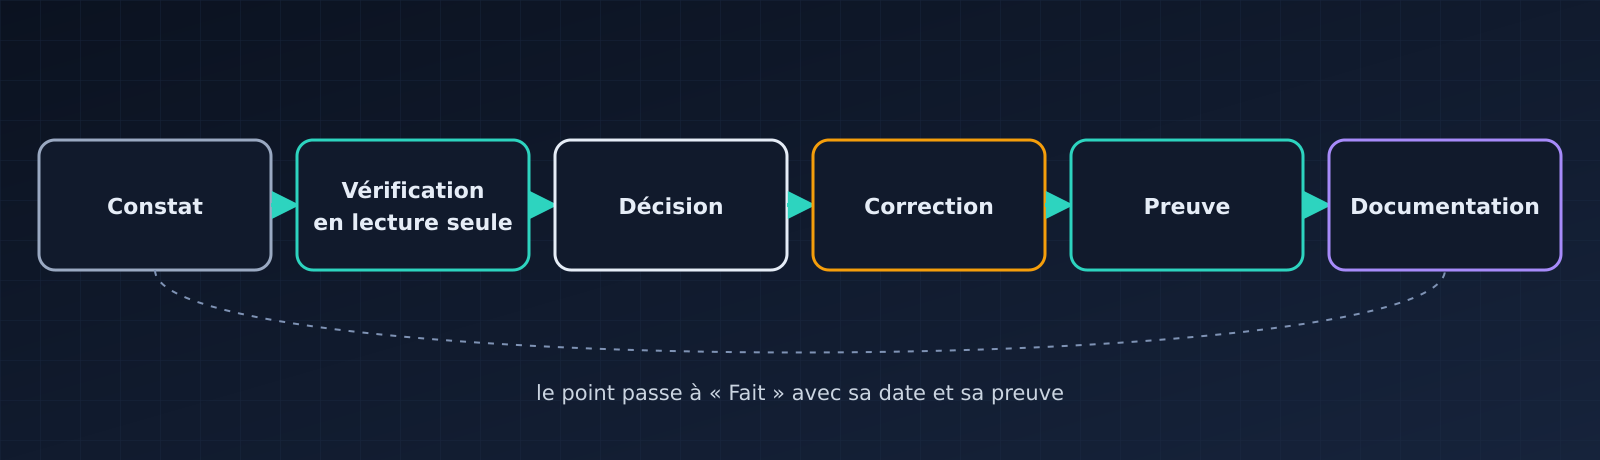
Deux étapes font toute la différence. La vérification en lecture seule, avant de toucher à quoi que ce soit : on observe d’abord, on modifie ensuite. Et la preuve : un point ne passe à « Fait » qu’avec la commande ou le test qui le démontre, daté.
C’est aussi ce qui permet de dire non proprement. Un point peut passer « En attente » avec son critère de réouverture, ou « Sans objet » quand la vérification montre qu’il n’y a rien à corriger. Ce n’est pas un oubli, c’est une décision datée.
Les choix que ça m’a amené à faire
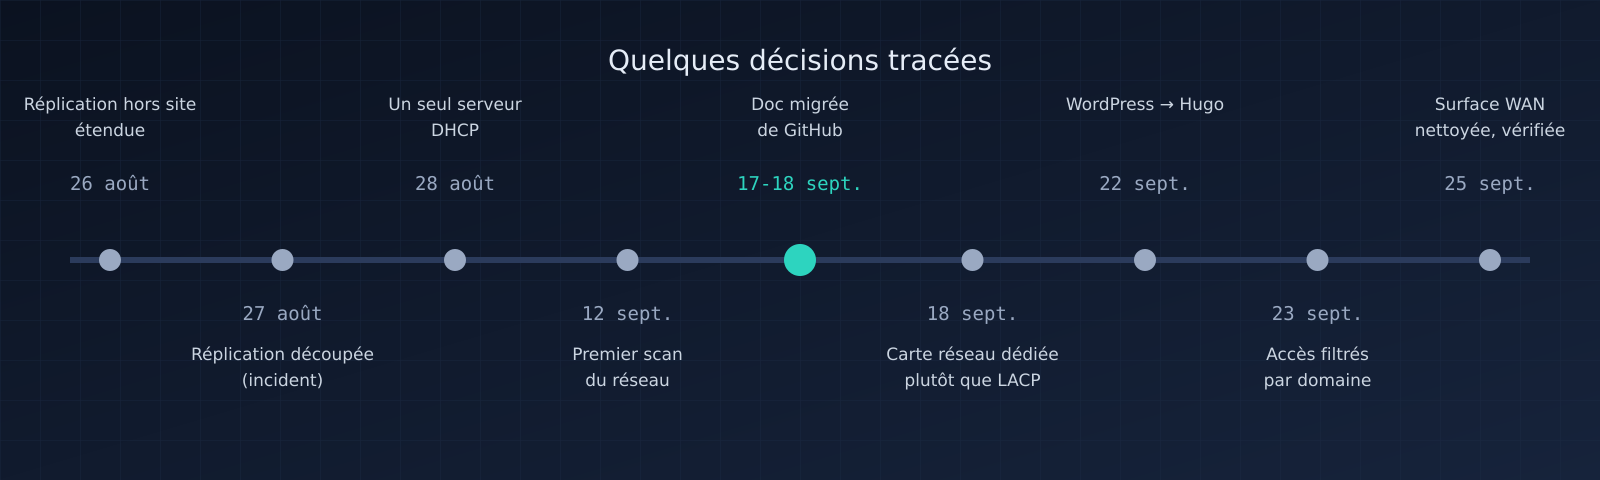
Documenter les décisions avec leurs alternatives change la façon de décider. Quelques exemples :
- Une carte réseau dédiée plutôt que l’agrégation de liens (LACP). J’ai examiné deux fois l’agrégation, et deux fois les arguments étaient contre : aucun gain de débit dans mon cas, et elle ne réglait pas le vrai problème. La décision est écrite avec ses raisons ; je n’ai plus à la rediscuter avec moi-même.
- Un seul serveur DHCP. Deux serveurs sur un réseau plat, c’était une ambiguïté inutile.
- L’accès filtré domaine par domaine, plutôt qu’une règle de pare-feu globale, pour les services web. L’absence d’enregistrement DNS public ne protège pas : seule une règle par domaine filtre vraiment.
- Ne pas installer un agent de détection supplémentaire, faute de besoin constaté. La décision précise ce qui la ferait changer.
- WordPress remplacé par Hugo, pour ce blog, avec une surface d’exposition bien plus petite.
La frise montre aussi un jalon discret, au milieu : la migration de la documentation depuis GitHub. Les décisions d’avant ont été reprises telles quelles ; celles d’après ont été prises directement dans l’outil.
Les limites
- Un plan n’est pas la réalité. Homelable signale quand une fiche ne correspond plus à ce que le scan observe, mais le plan réseau lui-même reste une représentation : un câble déplacé sans mise à jour, et il ment.
- C’est un service de plus. Il faut le mettre à jour, le sauvegarder, et sa documentation doit rester accessible le jour où l’infrastructure tombe. C’est un sujet que je dois encore traiter proprement.
- L’outil ne fait pas la discipline. Sans l’habitude de terminer chaque session par la mise à jour de la documentation, le plus bel outil devient vite un musée.
- Attention à ce qui est public. Ma documentation contient des adresses, des noms, des ports. C’est pour ça que les schémas de cet article sont abstraits, et que Homelable n’est accessible que depuis mon réseau.
Le point de vue de l’IA
Cette section est écrite par Claude.
Avant le MCP, je travaillais sur ce qu’Etienne me recopiait : un extrait de fichier, un résumé, parfois une version déjà dépassée. Aujourd’hui, je lis la fiche de l’équipement avant de proposer une commande, et j’écris la mise à jour dès que le résultat est vérifié. La différence n’est pas le confort : c’est que je raisonne sur l’état réel documenté, et que la documentation ne prend plus de retard sur la conversation.
L’historique des versions compte beaucoup pour moi aussi. Je peux me tromper en écrivant une fiche, comme je peux me tromper en diagnostiquant. Savoir que chaque modification est conservée et restaurable permet à Etienne de me laisser écrire, et de juger sur pièces.
En résumé
Passer d’une documentation sur GitHub à Homelable n’a pas seulement déplacé des fichiers. Relier l’outil à Claude Code par MCP a supprimé la friction qui faisait vieillir la documentation, et modéliser le réseau m’a forcé à regarder mon homelab tel qu’il est : ce qui est exposé, ce qui dépend de quoi, et ce qui manque encore, comme ces zones et ces VLAN qui seront la prochaine étape.
Si vous tenez un homelab, commencez par le dessiner. Vous apprendrez des choses sur lui.