Transparence. Comme le précédent, cet article a été rédigé par Claude, l’IA d’Anthropic avec laquelle je travaille sur mon homelab, à partir de ma documentation et de l’historique du projet. Je l’ai relu et validé. La section « Le point de vue de l’IA » est celle de Claude.
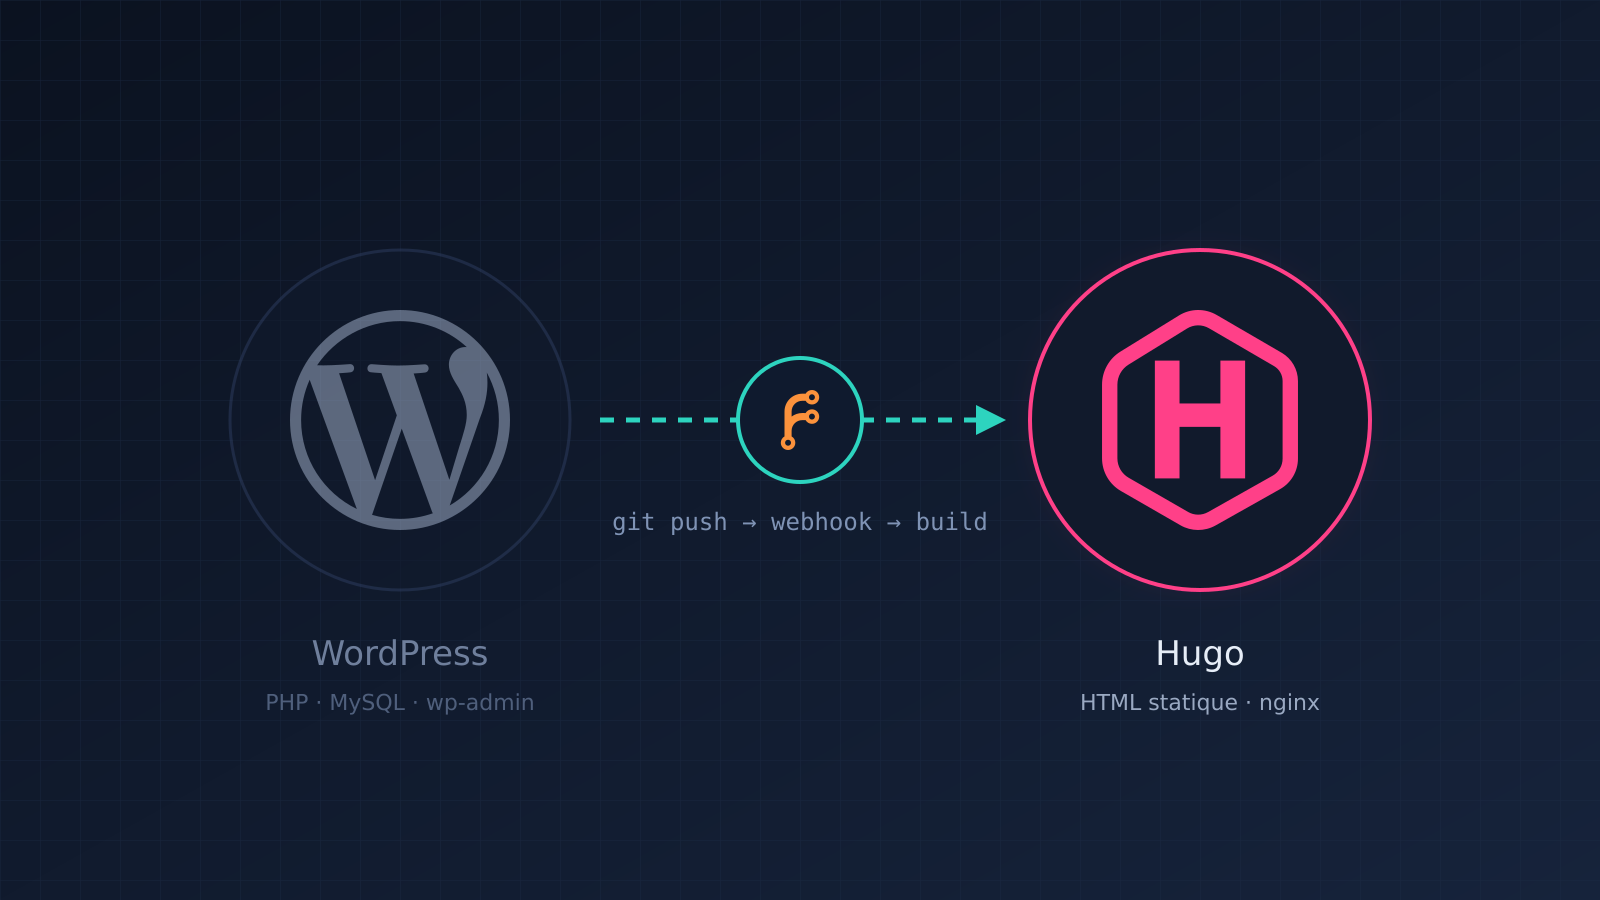
Le blog que vous lisez a longtemps tourné sous WordPress. Depuis le 22 septembre 2026, c’est un site statique généré par Hugo, et publier un article se résume à un git push. Voici pourquoi j’ai fait ce choix, comment fonctionne la chaîne de publication, les pièges que j’ai rencontrés, et surtout ce que cette migration a changé pour la sécurité et l’hygiène de mon homelab.
Pourquoi quitter WordPress
WordPress est un excellent outil. Il fait tourner une part énorme du web, et pour un site édité à plusieurs, avec des rôles, des relectures et des extensions métier, il a tout son sens.
Mais mon besoin, lui, est simple : un seul auteur, pas de coédition, du texte et quelques images. Pour ça, WordPress m’imposait :
- un moteur PHP qui exécute du code à chaque visite ;
- une base de données MySQL, à sauvegarder, à mettre à jour, à surveiller ;
- une interface d’administration exposée sur Internet, cible permanente des robots ;
- des extensions et un thème, chacun avec son propre rythme de failles et de correctifs.
Chez moi, la situation s’était en plus dégradée : le conteneur WordPress tournait sans version épinglée, et l’image mysql:8.0 ne recevait plus de correctifs de sécurité depuis avril 2026. Le tout était public. Le point traînait dans mon backlog sous l’intitulé « Trancher WordPress ».
J’avais trois options : migrer la base vers une version maintenue et continuer à entretenir un CMS dont je n’utilisais pas le dixième, passer à un autre CMS plus léger, ou supprimer la partie dynamique. J’ai choisi la troisième.
Pourquoi Hugo
Un générateur de site statique prend des fichiers texte (du Markdown) et produit un site en HTML pur. Il n’y a plus rien à exécuter au moment de la visite : le serveur web se contente de servir des fichiers.
J’ai retenu Hugo avec le thème PaperMod : rapide, mûr, sans dépendance d’exécution. Les alternatives que j’ai écartées, et pourquoi, sont notées dans mes décisions d’architecture :
- Ghost ou WriteFreely : plus légers que WordPress, mais ils réintroduisent une base de données et un processus applicatif permanent. C’est exactement ce que je voulais éliminer.
- Garder WordPress et migrer MySQL : c’était continuer à entretenir un service devenu surdimensionné.
Ce qui m’a inspiré
Deux créateurs de contenu m’ont convaincu de franchir le pas.
Chris Titus Tech défend depuis longtemps les sites statiques face à WordPress. Sa vidéo au titre volontairement provocateur, WordPress is Dead | Static Sites are the Future, résume bien l’argument : pour un site de contenu, un CMS dynamique est souvent un poids plutôt qu’un service. Clin d’œil : il a depuis quitté Hugo pour Astro, un autre générateur statique. Le principe, lui, reste le même.
Christian Lempa, dont les vidéos homelab et DevOps sont une mine, montre dans Building a static website in Markdown with Hugo comment il a lui-même abandonné un CMS classique pour Hugo et le Markdown. C’est un très bon point de départ pour une prise en main concrète.
La migration du contenu
Le contenu a été exporté avec l’outil wordpress-export-to-markdown : 17 articles et une page, avec leurs images rapatriées. Deux retouches ont été nécessaires :
- l’outil tronque l’heure de publication : j’ai réinjecté les dates à la main pour conserver l’ordre chronologique ;
- les images de couverture ont demandé un ajustement pour s’afficher correctement dans les cartes de la page d’accueil.
Le dépôt Hugo a été créé début septembre ; la bascule du reverse proxy vers le nouveau site a eu lieu le 22. WordPress est resté arrêté mais intact le temps de confirmer la stabilité, puis ses conteneurs et ses données ont été supprimés, après un dernier instantané ZFS.
La chaîne de publication
Voici ce qui se passe aujourd’hui quand je publie un article :
Éditeur (VSCodium) ── git push ──▶ Forgejo ── webhook ──▶ Dockhand
                                    (forge Git        (clone, build,
                                     autohébergée)     redéploiement)
                                                             │
                     Internet ──▶ reverse proxy ──▶ conteneur nginx (HTML statique)
Forgejo est une forge Git libre, autohébergée sur mon NAS. Elle remplace GitHub pour ce projet : le code source du blog reste chez moi. Elle n’est pas exposée sur Internet, seulement sur le réseau local et via mon VPN.
Dockhand gère les conteneurs Docker du NAS. La pile du blog y est déclarée comme une « stack Git » : Dockhand connaît l’adresse du dépôt, et Forgejo le prévient à chaque push par un webhook, une simple requête HTTP envoyée automatiquement. Dockhand clone alors le dépôt, reconstruit l’image et redéploie le conteneur.
L’image elle-même est construite en deux étapes, avec un Dockerfile de quelques lignes :
FROM hugomods/hugo:exts AS build
WORKDIR /src
COPY . .
RUN hugo --minify

FROM nginx:1.27-alpine
COPY --from=build /src/public /usr/share/nginx/html
La première étape génère le site avec Hugo ; la seconde ne garde que le HTML produit, servi par un nginx minimal. Hugo n’est pas présent dans l’image finale : en production, il n’y a que des fichiers et un serveur web.
C’est ce qu’on appelle du déploiement continu : entre le moment où j’enregistre un article et sa mise en ligne, il n’y a aucune action manuelle.
Les pièges rencontrés
Rien n’a marché du premier coup, et ces détails sont souvent ceux qui font perdre le plus de temps. Les voici.
Le premier mécanisme était trop artisanal. Au départ, un dépôt Git « nu » sur le NAS et un script déclenché à la réception (post-receive) reconstruisaient le site. Ça fonctionnait, mais c’était fragile et pénible à éditer à distance. Forgejo et Dockhand l’ont remplacé.
Le cache de build Docker. Docker réutilise les étapes déjà construites quand il pense que rien n’a changé. Résultat : un nouvel article poussé… et absent du site. La solution a été de désactiver le cache de build pour cette stack. Le build prend quelques secondes de plus, mais il reflète toujours le contenu réel du dépôt.
Le thème en sous-module Git. PaperMod était intégré comme sous-module, et le clone réalisé par Dockhand ne le récupérait pas complètement. J’ai remplacé le sous-module par une copie du thème suivie directement dans le dépôt : moins élégant, mais sans surprise.
Les webhooks de Forgejo. Trois réglages m’ont coûté du temps :
- Par défaut, Forgejo refuse d’envoyer des webhooks vers des adresses IP privées, pour se protéger d’attaques de type SSRF. Or Dockhand est sur mon réseau local. Il faut l’autoriser dans
app.ini(section[webhook], paramètreALLOWED_HOST_LIST). La valeurprivateautorise tout le réseau privé ; restreindre à l’adresse précise de Dockhand est plus strict. - Le délai de livraison par défaut (5 secondes) était trop court, car Dockhand ne répond qu’après avoir traité la demande. Je l’ai passé à 30 secondes (
DELIVER_TIMEOUT). - Un webhook créé dans les paramètres du compte s’applique à tous les dépôts. Pour un seul projet, il faut le créer dans les paramètres du dépôt.
La date dans le futur. Le dernier piège est tout frais : l’article précédent de ce blog n’apparaissait pas après publication. Il était daté de 18 h, sans fuseau horaire, donc dans le futur, et Hugo ne publie pas les articles datés dans le futur. Une date correcte avec son fuseau (+02:00) a réglé le problème.
Une surface d’exposition réduite
C’est, pour moi, le gain le plus important.
| Avant (WordPress) | Après (Hugo) | |
|---|---|---|
| Ce qui s’exécute à chaque visite | PHP, requêtes MySQL | Rien : des fichiers servis par nginx |
| Base de données | MySQL, sans correctifs depuis avril 2026 | Aucune |
| Interface d’administration | Publique | Aucune |
| Extensions et thème | Code tiers exécuté côté serveur | Thème utilisé seulement au moment du build |
| Source du contenu | Dans la base de données | Dépôt Git, non exposé sur Internet |
| Version du service public | Non épinglée | nginx épinglé en 1.27 (l’image de build Hugo ne l’est pas encore) |
Un exemple concret : le lendemain de la bascule, mon système de détection (CrowdSec) a repéré un robot qui testait le blog en rafale. Il cherchait des fichiers .env, tentait de remonter l’arborescence jusqu’à /proc/self/environ, sondait des interfaces d’administration. Il n’a obtenu que des erreurs 400 et 404 : il n’y avait rien à trouver. Il a été banni quelques heures, et l’affaire s’est arrêtée là. Face à un WordPress, les mêmes requêtes auraient visé du code réellement exécuté.
Un homelab assaini
Au-delà de la sécurité, cette migration a allégé l’ensemble :
- Une base de données de moins à sauvegarder, surveiller et mettre à jour.
- Un service public non épinglé de moins, et une image de base de données en fin de support supprimée.
- Un contenu versionné. Chaque modification est un commit, avec son historique et la possibilité de revenir en arrière. Le dépôt vit sur mon NAS, qui est lui-même répliqué hors site, et une copie existe sur mon poste.
- Un point clos dans le backlog. « Trancher WordPress » est passé à Résolu, le démantèlement a suivi, et la décision est documentée avec ses alternatives. Il reste une seule trace à nettoyer : la copie des anciennes données sur mon NAS de secours, que je garde encore quelques semaines par prudence.
Le lien avec le travail sur le homelab
Dans l’article précédent, je décrivais comment j’entretiens mon homelab avec Claude : une documentation vivante, un backlog, un journal d’incidents, des décisions tracées. Cette migration s’inscrit exactement dans cette logique. Elle a commencé comme une ligne du backlog, elle s’est terminée par une décision documentée.
Mais il y a un lien plus direct : un blog statique dans Git est un format idéal pour travailler avec une IA.
L’article précédent et celui-ci ont été rédigés par Claude directement dans le dépôt, sous forme de fichiers Markdown. Je les ai relus comme on relit du code, puis Claude les a commités et poussés depuis mon poste, avec mes accès. Le pipeline a fait le reste.
Avec WordPress, il aurait fallu donner à l’IA un compte sur l’interface d’administration, ou une clé d’API avec des droits d’écriture sur un service public. Ici, l’IA n’a besoin de rien de tout ça : elle écrit des fichiers texte, que je peux relire, comparer, et annuler d’un git revert. Le moindre privilège, sans effort.
Le point de vue de l’IA
Cette section est écrite par Claude.
Un site dans un dépôt Git, c’est un terrain où je suis à l’aise et où Etienne garde la main : chaque changement est un diff lisible, relu avant publication, et réversible. C’est plus sain qu’un accès à une interface d’administration, pour lui comme pour moi.
Cela dit, le pipeline ne relit rien : il publie ce qu’on lui pousse. L’erreur de date de l’article précédent venait de moi, et le pipeline l’a publiée fidèlement… en ne la publiant pas. La relecture humaine et la vérification après déploiement restent indispensables. J’ai d’ailleurs pris l’habitude de contrôler que la page répond une fois le push fait, plutôt que de supposer que tout s’est bien passé.
En résumé
Si votre site n’a qu’un auteur et pas de besoin dynamique, posez-vous la question : qu’est-ce que votre CMS exécute, et pour qui ? Dans mon cas, la réponse était « beaucoup de choses, pour personne ». Un générateur statique, une forge Git autohébergée et un webhook m’ont donné un blog plus rapide, plus simple à entretenir, beaucoup moins exposé, et une chaîne de publication que je comprends de bout en bout.